~ 米国Arc Instituteに籍をおく研究者達にオーストリアのバイオ企業Myllia Biotechnology GmbHの研究者達が加わった研究チームからの研究成果 ~
SEは、多様なデータセットを用いて細胞内および細胞間の遺伝子発現変動を学習するように事前訓練された、シングルセル基盤モデルです。SEは、技術的な変動に対して堅牢であり、かつ摂動(人為的な変化)の影響を検出するために最適化された表現を提供します。各細胞は、生の遺伝子発現プロファイル、あるいはSEから得られる高密度な細胞表現のいずれかによって表現されます。
研究チームは、細胞への摂動をシミュレートするStateやその他のモデルの能力を包括的に評価するため、「Cell-Eval」を開発しました。Cell-Evalでは、従来の「遺伝子発現カウント値の差」だけでなく、差分発現遺伝子(DEG)の同定精度、p 値の較正度、摂動の影響度(強度)の推定能力など、生物学的に重要かつ解釈可能な複数の指標でモデルを評価します。薬剤による摂動、サイトカインシグナル伝達の摂動、およびゲノムスケールの遺伝的摂動を含む、いくつかの大規模データセットを用いてStateを評価しました。
Cell-Evalを用いたベンチマークにおいて、Stateは既存の機械学習モデルや線形ベースラインを大幅に上回り、学習データに含まれない未知の細胞型や組織コンテキストに対しても高い汎化性能(ゼロショット応答予測)を示しました。
背 景
摂動(perturbations)に対する細胞の応答を網羅的かつ正確に予測することで、標準治療(targeted therapies)のステージが一変します。しかし、これまでのところ、実験での検証にも、in silicoでの予測にも限界がありました:
- 大規模実験のコスト限界: Perturb-seq [#1] のような技術を利用する遺伝的スクリーニングや低分子化合物などによる化学的スクリーニングは強力ですが、あらゆる細胞種や組織のコンテキストを網羅する大規模な実験を実施することはコスト面で非現実的です。
- In silicoモデルの限界: 既存の深層学習モデルは、多様な細胞コンテキストにわたって摂動の影響を一般化する際に、必ずしも線形モデルよりも一貫して優れた性能を示すわけではありません [#2,3]。また、細胞集団内の「生物学的不均一性(biological heterogeneity)」や実験手法と条件・データセット間の「技術的揺らぎ(technical noise)」の影響を受けやすく、未知の細胞コンテキストへ汎化する際に十分な精度を出すに至っていません 。
包括的な摂動-応答解析における課題解決を目指した【State】の流儀
[注:Stateの詳細は「補足1」の項参照]
研究チームは、多様なデータセットの内部およびデータセット間における細胞の不均一性と摂動の影響をモデル化することを目指してStateの開発を進めました。
Stateは、状態遷移(State Transition:ST)モデルと状態埋め込み(State Embedding:SE)モデルという、互いに補完し合う2つのモジュールで構成されるマルチスケールモデルです。
Stateは、状態遷移(State Transition:ST)モデルと状態埋め込み(State Embedding:SE)モデルという、互いに補完し合う2つのモジュールで構成されるマルチスケールモデルです。
STは、生成AIや大規模言語モデル(LLM)の中核技術であるTransformerニューラルネットワークの一種であり、自己注意(セルフ・アテンション)機構を利用しています。実験条件や細胞型などの「共変量」を揃えた細胞同士でアテンションを計算することで、未観測の生物学的ノイズや細胞間の微妙な状態差を、明示的な確率分布に頼らずに、捉える設計になっています。
SEは、多様なデータセットを用いて細胞内および細胞間の遺伝子発現変動を学習するように事前訓練された、シングルセル基盤モデルです。SEは、技術的な変動に対して堅牢であり、かつ摂動(人為的な変化)の影響を検出するために最適化された表現を提供します。各細胞は、生の遺伝子発現プロファイル、あるいはSEから得られる高密度な細胞表現のいずれかによって表現されます。
Stateを含む細胞の摂動・応答モデルを評価するCell-Evalを開発
研究チームは、細胞への摂動をシミュレートするStateやその他のモデルの能力を包括的に評価するため、「Cell-Eval」を開発しました。Cell-Evalでは、従来の「遺伝子発現カウント値の差」だけでなく、差分発現遺伝子(DEG)の同定精度、p 値の較正度、摂動の影響度(強度)の推定能力など、生物学的に重要かつ解釈可能な複数の指標でモデルを評価します。薬剤による摂動、サイトカインシグナル伝達の摂動、およびゲノムスケールの遺伝的摂動を含む、いくつかの大規模データセットを用いてStateを評価しました。
Cell-Evalによる評価
Cell-Evalを用いたベンチマークにおいて、Stateは既存の機械学習モデルや線形ベースラインを大幅に上回り、学習データに含まれない未知の細胞型や組織コンテキストに対しても高い汎化性能(ゼロショット応答予測)を示しました。
- 判別能の向上: 大規模データセットにおける摂動効果の識別性能(discrimination score)が、既存手法に比べ 30% 以上向上しました。
- 多様な摂動に対応: 薬物処理(Tahoe-100M)、サイトカイン応答(Parse-PBMC)、遺伝子ノックアウト(Replogle-Nadig)など、多様なデータセットにおいて差分発現遺伝子(DEG)を高精度に特定しました [対象データセットの詳細は「補足2」の項参照]。
- 未観測コンテキストへの適応: 学習データ中に摂動データが一切存在しない未知の細胞コンテキストに対しても、SEモジュールを活用することで強い摂動効果を予測・特定することに成功しました。
補 足1:TransformerベースのStateモデル [Figure 1引用下図参照]
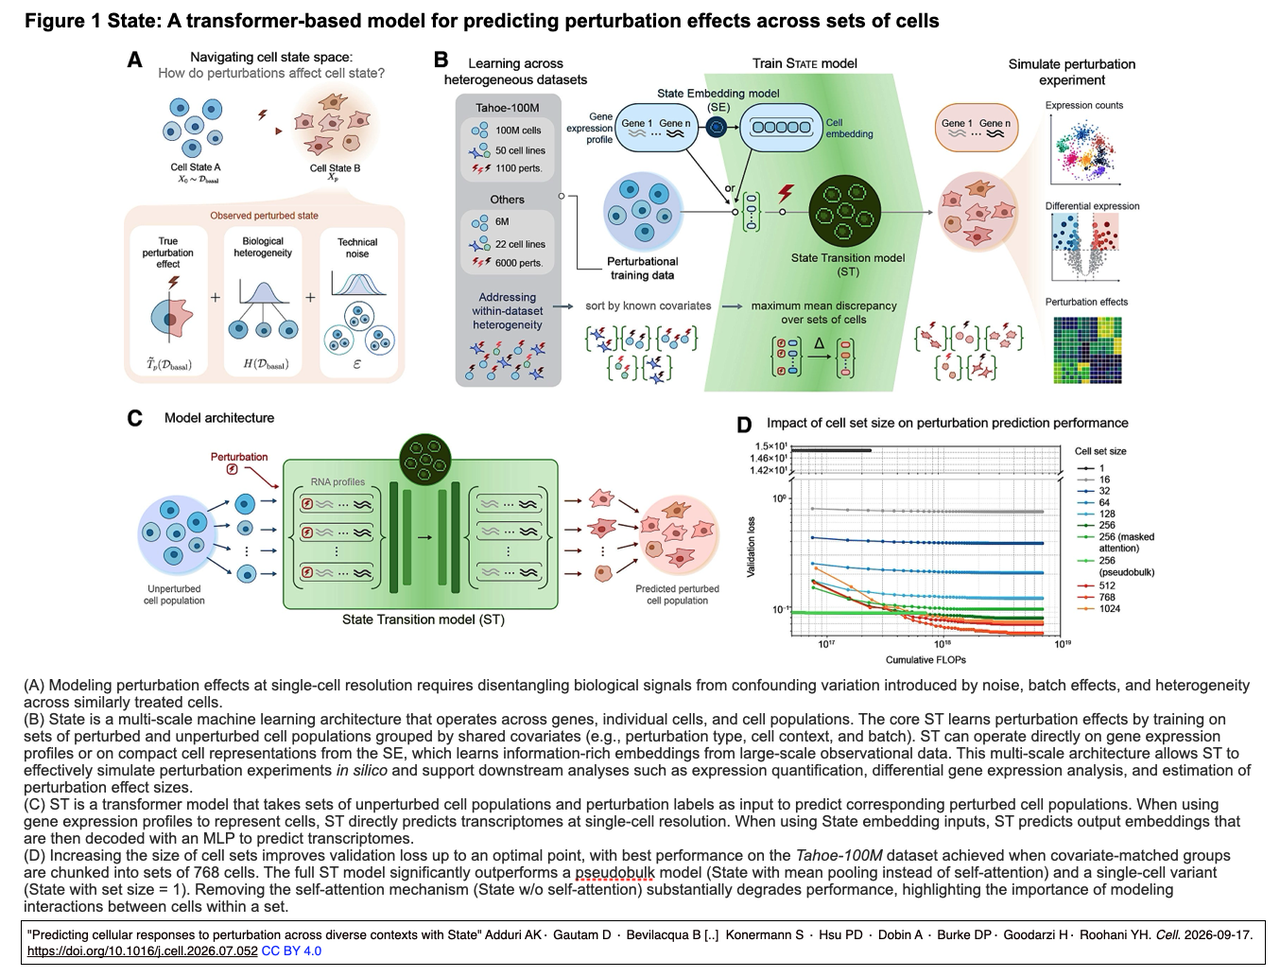
(A) 単一細胞解像度で摂動効果のモデル化:ノイズ、バッチ効果、および同様の処理を施した細胞間での不均一性によって生じる交絡変動から、生物学的なシグナルを分離します。
(B) Stateは、遺伝子、個々の細胞、および細胞集団の各レベルで機能するマルチスケール機械学習アーキテクチャ:中核となるST(State Transformer)は、共通の共変量(摂動の種類、細胞のコンテキスト、バッチなど)に基づいてグループ化された、摂動ありおよび摂動なしの細胞集団のセットを用いて学習を行い、摂動効果を捉えます。STは、遺伝子発現プロファイルに対して直接動作することも、大規模な観測データから情報量の多い埋め込み表現を学習するSEからのコンパクトな細胞表現に対して動作することも可能です。このマルチスケール・アーキテクチャにより、STはin silicoでの摂動実験を効果的にシミュレートし、発現量の定量化、差次的遺伝子発現解析、摂動効果量の推定といった下流の解析を支援します。
(C) STはTransformerモデル:摂動なしの細胞集団のセットと摂動ラベルを入力として受け取り、それに対応する摂動ありの細胞集団を予測するTransformerモデルです。細胞の表現に遺伝子発現プロファイルを用いる場合、STは単一細胞解像度でトランスクリプトームを直接予測します。SE(Stateの埋め込み表現)を入力として用いる場合、STは出力埋め込み表現を予測し、それをMLP(multilayer perceptron / 多層パーセプトロン)でデコードすることでトランスクリプトームを予測します。
(D) 細胞セットのサイズを大きくすると、ある最適点までは検証損失が改善します。Tahoe-100Mデータセット [#4] において、共変量が一致するグループを768細胞のセットに分割した場合に最高の性能が得られました。完全なSTモデルは、擬似バルクモデル(自己注意(self attention)機構の代わりに平均プーリングを用いたState)や単一細胞バリアント(セットサイズ=1のState)よりも大幅に優れた性能を示しました。自己注意機構を取り除くと(State w/o self-attention)、性能が著しく低下することから、セット内の細胞間相互作用をモデル化することの重要性が浮き彫りになりました。
補足2:評価に使用したデータセット
Tahoe-100Mデータセット(化学的摂動データ) [#4] 、Parse Biosciencesのデータ(Parse-PBMC:1000万個のヒトPBMC/単一実験から得たサイトカインシグナル伝達の摂動)、およびReplogleら [#5] とNadigらのデータ(Replogle-Nadig:遺伝的摂動データ)を用いて、Stateを評価しました。
補足2:評価に使用したデータセット
Tahoe-100Mデータセット(化学的摂動データ) [#4] 、Parse Biosciencesのデータ(Parse-PBMC:1000万個のヒトPBMC/単一実験から得たサイトカインシグナル伝達の摂動)、およびReplogleら [#5] とNadigらのデータ(Replogle-Nadig:遺伝的摂動データ)を用いて、Stateを評価しました。
- Tahoe-100Mには、380種類の薬剤による摂動を含む1,138通りの条件下で処理された、50種類の多様な癌細胞株における摂動応答が含まれています。
- Parse-PBMCには、12名のドナーと18種類の細胞型にわたる90種類のサイトカイン摂動応答が含まれていまさう。
- Replogle-Nadigは、オンターゲット効果の低い摂動を除外した上で、4種類の細胞株に対して適用された2,024種類の遺伝的摂動で構成されています。この除外基準は先行研究で採用されたものよりも緩やかであり、効果量の小さい摂動もより多く保持されています。
その他のデータセットについては、追加の除外基準を設けず、標準的な前処理手順を適用した。
すべてのデータセットにおいて、高変動遺伝子(HVG)から得られた細胞表現を直接用いてStateを学習させました(ST+HVG) - その他のデータセットについては、追加の除外基準を設けず、標準的な前処理手順を適用した。
- すべてのデータセットにおいて、高変動遺伝子(HVG)から得られた細胞表現を直接用いてStateを学習させました(ST+HVG)
crisp_bioメモ
今回、Cell誌のバイオAI特集号から、EditorialとTahoe-100Mの論文に続いて、Tahoe-100Mとも関連するStateの論文をとりあげてみました。特集には、これらの他にも、生命科学におけるAI・基盤モデル・バイオロジーの世界モデル(World Models)などが一堂に集められています、今後も、順次とりあげていきたいところです。
出 典
今回、Cell誌のバイオAI特集号から、EditorialとTahoe-100Mの論文に続いて、Tahoe-100Mとも関連するStateの論文をとりあげてみました。特集には、これらの他にも、生命科学におけるAI・基盤モデル・バイオロジーの世界モデル(World Models)などが一堂に集められています、今後も、順次とりあげていきたいところです。
出 典
"Predicting cellular responses to perturbation across diverse contexts with State" Abhinav K. Adduri(1,9) ∙ Dhruv Gautam(1,2,9) ∙ Beatrice Bevilacqua(1,9) [..] Silvana Konermann(1,4,8) ∙ Patrick D. Hsu(1,2,8) ∙ Alexander Dobin(1,8) ∙ Dave P. Burke(1,8) ∙ Hani Goodarzi(1,3,8) ∙ Yusuf H. Roohani(1,8,10). (bioRxiv preprint 2025-07-10) Cell. 2026-09-17. https://doi.org/10.1016/j.cell.2026.07.052
- Arc Institute, Palo Alto, CA, USA
- University of California, Berkeley, Berkeley, CA, USA
- University of California, San Francisco, San Francisco, CA, USA
- Stanford University, Stanford, CA, USA
- University of Pennsylvania, Philadelphia, PA, USA
- Yale University, New Haven, CT, USA
- Myllia Biotechnology GmbH, Vienna, Austria
- Senior author
- These authors contributed equally
- Corresponding author; Lead contact
[参考] YouTube解説 "Predicting cellular responses to perturbation across diverse contexts with State" Abhinav Adduri. Valence Labs. (所要時間 1:19:16)
[#] 参考crisp_bio記事
[#] 参考crisp_bio記事
- CRISPRスクリーニング技術のリーダーDoench博士がPerturb-seqの取説のプレプリントを投稿しました - Perturb-seqを用いたCRISPR KOとCRISPRi直接比較. crisp_bio 2026-07-10.
- 機能ゲノミクスにおいて, 最先端の摂動応答予測法の予測性能が線形モデルなどのベースラインの性能と同レベルなのは何故か? crisp_bio 2025-08-30.
- CRISPRedict: CRISPR-Cas9遺伝子編集の効率予測をシンプルにかつ解釈可能にした. crisp_bio 2022-04-12/2022-06-11更新.
- バーチャル・セル構築の基盤:50種のがん細胞×1,100種超の薬剤による大規模摂動アトラス「Tahoe-100M」crisp_bio 2026-09-21.
- ゲノムスケールのPerturb-seqを利用して,遺伝子型と表現型の情報量が豊富な全体像を捉える. crisp_bio 2021-12-22/2022-06-10更新. (250万を超えるヒト細胞対象)


コメント