crisp_bioでは9月25日に、Anthropic社の生命科学研究チームが大規模Claude AIエージェント群を用いて見つけた新たな逆転写酵素システム「ART(Array-associated Reverse Transcriptases)」を紹介しました。本日(26日)は、そのNature News解説記事に続き、同記事でコメントを掲載されていたBrian L. Hie博士(スタンフォード大/Arc Institute)が率いる研究チームによるbioRxivプレプリントを紹介しています。
Brian L. Hie博士といえば、Arc Instituteの共同設立者の一人であるPatrick D. Hsu博士らと共にゲノムを生成するAI「Evo」を開発した中心人物です。
今回の研究では、アラインメントフリーでゲノム・メタゲノムから非コード領域の共進化シグナルを掘り起こすフレームワーク「Minerva」を発表しました。
研究の背景と従来手法の課題
原核生物やメタゲノムには多様な非コードRNA(ncRNA)が存在しますが、従来の探索パイプラインは「タンパク質コード領域」や「既知配列との相同性(BLAST等)」に依存してきたため、多くのncRNAが未注釈のまま残されています。
機能的に連携するアミノ酸やヌクレオチドは、その立体構造や相互作用を保つために相補的な変異(共変異)を起こし、配列上に共進化の痕跡を残します。
従来の共進化解析(InfernalやRfamなど)は多重配列アラインメント(MSA)を前提としていましたが、一次配列よりも二次構造が保存されているRNAでは適切なMSAの構築が困難であり、多大な計算コストも課題でした。
アラインメントフリーの共進化マイニング「Minerva」
研究チームは、配列の文脈から隠されたトークンを予測する「マスク化言語モデル(MLM)」の特性に着目しました。RNAのステム構造のように物理的にペアを組む塩基同士は強い統計的依存関係を持つため、MLMを学習させるだけで自然と立体構造や塩基対のルールがモデル内部に獲得されます。
Minervaは、入力配列からアテンションマップや変異応答(Categorical Jacobian)を抽出することで、MSA無しで(MSAフリー)2次元の共進化マップ(塩基対、偽ノット、タンパク質接触面、反復モチーフ)を直接生成します。
hCom2ゲノム解析における3つの主要成果
ヒト腸内細菌叢由来の150種のゲノムおよびプロファージ群にMinervaを適用することで、ncRNAから以下の知見を得るに至りました:
- UG27およびDRT2逆転写酵素(RT)システムの機能解明
- プロファージに存在するUG27 RTシステムにおいて、構造が厳密に保存されたncRNAアレイがcDNAヘアピン生成の「鋳型(Template)」として機能することを解明。
- 抗ファージ防御システムDRT2において、擬似ノット(Pseudoknot)を持つncRNAと、従来のアノテーションで落とされていた隠れたORF(Hidden ORF)を同定。
- TwoAYGGAY RNAファミリーの構造拡張
- Pseudomonadotaに存在するTwoAYGGAY RNAが、従来の知見を超える大きな二次構造拡張部とフランキング反復モチーフを持つことを提示。
- 教師なしでのコドン周期性(Codon Periodicity)の獲得
- モデルがDNAレベルで3塩基周期(コドン構造)を自律的に学習しており、アノテーション誤りによるタンパク質コード領域の欠損や境界エラーを自動修復できることを実証。
Arc Institute(Minerva)と Anthropic(Claude)の対比
[注] 以下の対比表は画像としてアップロードされています(クリックすると拡大表示されます)
両システムの相補性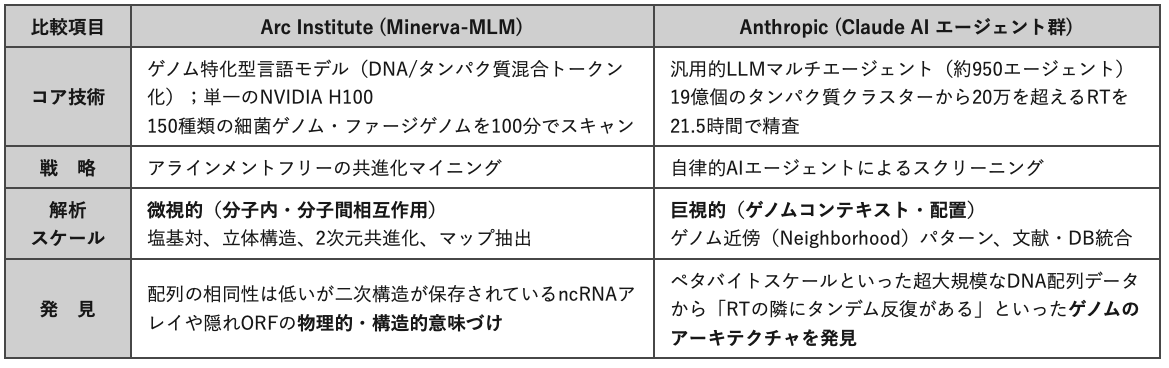
こうして見ると、「Claudeのような汎用的AIエージェントが大規模ゲノムDBから「特徴的なアレイを伴うRT」などの巨視的パターンを自動スクリーニングし、見つかった領域の精密な構造解析や共進化マップの解読をMinervaのようなドメイン特化型ゲノム言語モデルが担う」といった統合ワークフローの姿が浮かび上がってきます。
補足:Minervaのモデル構成と命名の由来
- モデル基盤: タンパク質とDNAを混合トークン化するマルチモーダルモデル「gLM2」をベースに、非コード領域1兆トークンを追加事前学習した「Minerva-MLM」を採用しています。
- 名前の由来: 論文中では「フクロウを連想させるEvoにちなみ、フクロウを従えるローマ神話の知恵の女神Minervaから命名した」"We named our framework Minerva after the Roman goddess of wisdom, who is accompanied by an owl (in reference to Evo)."と説明されています。
出 典
"Coevolutionary mining of prokaryotic non-coding elements with a genome language model" David B. Li(1,2,3,15), Garyk Brixi(2,3,4,15) [..] Michael A. Fischbach(1,3,12,16), Brian L. Hie (2,13,14,16). bioRxiv. 2026-09-24 (preprint). https://doi.org/10.64898/2026.09.22.753630
- Department of Bioengineering, Stanford University, Stanford, CA, USA
- Arc Institute, Palo Alto, CA, USA
- ChEM-H Institute, Stanford University, Stanford, CA, USA
- Department of Genetics, Stanford University School of Medicine, Stanford, CA, USA
- Department of Mathematics, Stanford University, Stanford, CA, USA
- DOE Joint Genome Institute, Lawrence Berkeley National Laboratory, Berkeley, CA, USA
- Department of Biochemistry, Stanford University, Stanford, CA, USA
- Department of Microbiology and Immunology, Stanford University, Stanford, CA, USA
- Department of Psychiatry and Behavioral Sciences, Stanford University, Stanford, CA, USA
- Howard Hughes Medical Institute, Stanford University, Stanford, CA, USA
- Structural Biology Program, Sloan Kettering Institute, Memorial Sloan Kettering Cancer Center, New York, NY, USA
- Chan Zuckerberg Biohub, Stanford, CA, USA
- Department of Chemical Engineering, Stanford University, Stanford, CA, USA
- Stanford Data Science, Stanford University, Stanford, CA, USA
- Contributed equally
- Corresponding author


コメント