背 景
細菌やアーケアの免疫システムである「CRISPR-Casシステム」の発見と解明は、多様なCasタンパク質の正確な分類体系が存在することで、加速することが期待されます。しかし、「鶏と卵」の関係に似て、実験による直接的な同定は困難なため、計算科学(AI・機械学習)による高精度な分類が期待されています。
成 果
中国・西北農林科技大学の研究チームは今回、最新のタンパク質言語モデルESM1bに、PSSM(position-specific scoring matrix / 位置特異的スコアマトリックス)をベースとする伝統的な進化学的プロファイリングを融合することで、これまでで最も高性能なCRISPR/Casシステムの機械学習分類器PrePssmCasを開発し、BMC Bioinformatics 誌掲載論文から報告しました。
詳 細
PrePssmCasの技術的仕組み [Fig. 1引用下図参照(クリックすると拡大表示されます)]
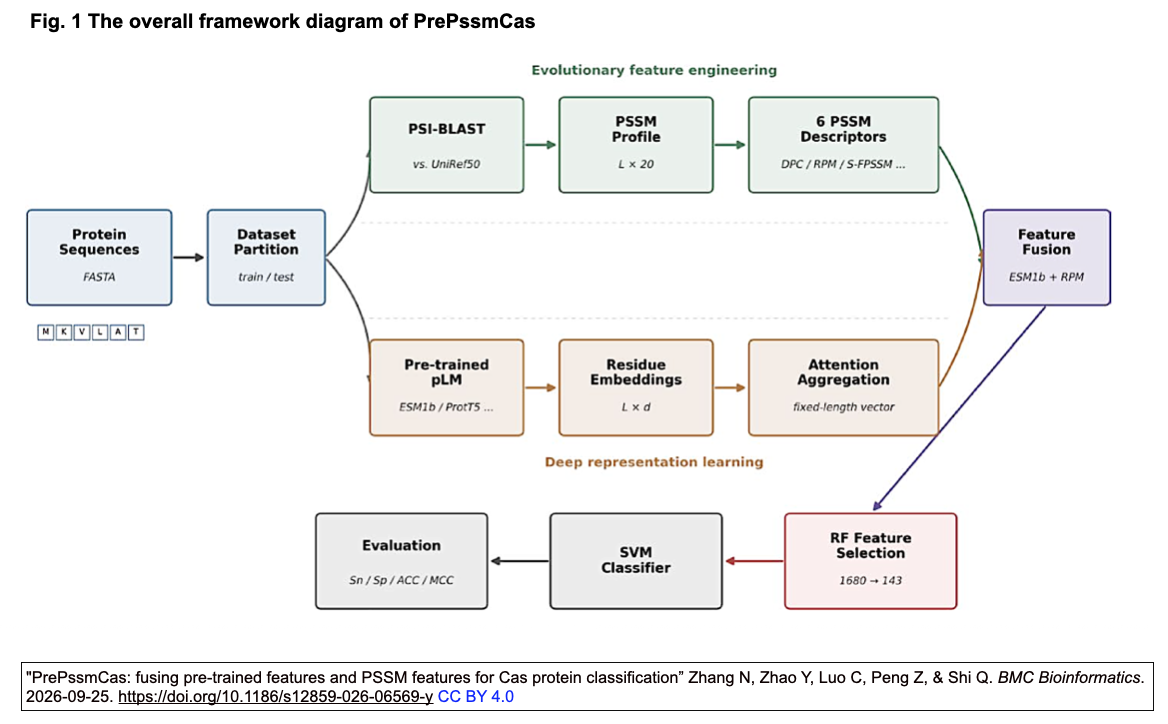
1. 2つの相補的な特徴量の融合 [詳細は補足の項を参照して下さい]
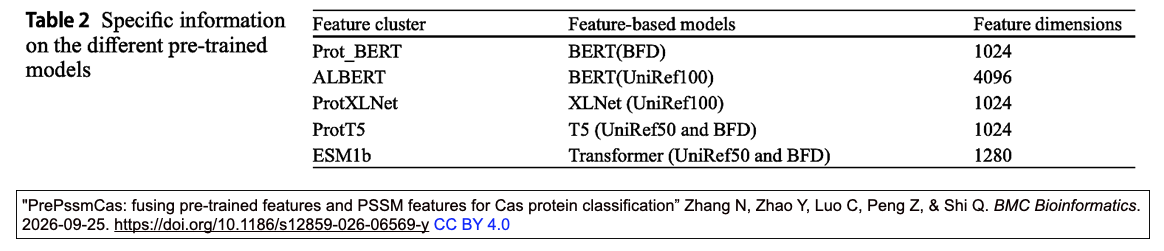
- 事前学習済みタンパク質言語モデル: モデルを比較検討した結果、Metaが開発した深層学習モデル ESM1b を選択し、アミノ酸の長距離構造・機能・文脈情報を抽出(87次元)。[論文Table 2引用下図参照(クリックすると拡大表示されます)]
- 位置特異的スコア行列(RPM-PSSM): データベース検索(BLAST)によって得られる、配列部位ごとの進化的な保存性・変異耐性プロファイルを抽出(56次元)。[論文Table 1引用下図参照(クリックすると拡大表示されます)]
2. アテンション機構と特徴量選択
- アテンション機構:タンパク質配列内の重要部位へ適応的に重みを付与。
- ランダムフォレストによる最適化:膨大な次元数から、分類に真に貢献する143次元(言語モデル由来87次元+PSSM由来56次元)のコンパクトな特徴量に絞り込むことで、過学習(overfitting)を防ぎ汎用性を向上。
分類性能の検証結果
- 高精度達成:独立した検証データセットにおいて、精度(Accuracy)97.98%、マシューズ相関係数(MCC)0.962という極めて高い予測性能を実証。
- 既存ツールを凌駕:従来の主要7ツール(HMMCAS, CASPredict, CRISPRone, CRISPRCasFinder, CRISPRCasTyper, CRISPRloci, CRISPRCasStack)と比較し、最も優れた性能を示した。従来最高精度だったCRISPRCasStackと比較しても、精度で3.91ポイント、MCCで9.60ポイント向上。
研究の意義と課題
- ハイブリッドアプローチの証明:「大型言語モデルの登場により伝統的な配列解析(PSSM等)は不要になったか」という議論に対し、言語モデルが捉えきれない進化的なアライメント情報をPSSMが補完できることを実証した。
- 今後の課題:既存のデータベースと相同性が極めて低い未知のCasタンパク質(遠縁のホモログ)や、大規模メタゲノムデータに対する汎用性の検証が今後の課題として挙げられている。
補 足:ESM1bではPSSMまでカバーできないのか?
[注] この項は主として出典のDISCUSSIONセクションに準拠しています。
[注] この項は主として出典のDISCUSSIONセクションに準拠しています。
ESMなどのタンパク質言語モデル(PLM)は、大規模な配列データセットを学習することで、タンパク質空間全体に通底するアミノ酸の共起関係や構造的制約といった「汎用的・暗黙的な進化パターン」を獲得しています。
しかし、PSSM(位置特異的スコアリング行列)が提供するような「特定ファミリーの直接的・明示的な進化プロファイル」を単一配列から完全に捉えることには限界があります。その主な理由は以下の4点です。
1. 推論時の入力情報の違い(単一配列 vs 多重配列アラインメント)
- PLM:事前学習時に数億の配列を読み込んでいますが、実際に特徴量を抽出(推論)する際には「単一のアミノ酸配列」のみを入力します。
- PSSM:対象の配列をクエリとし、PSI-BLAST等を用いて実際のデータベースから近縁の相同配列(ホモログ)群を検索・収集し、多重配列アラインメント(MSA)を作成して構築されます。
単一配列の文脈のみを評価するPLMでは、「実際の生物界において、そのタンパク質の近縁種群が特定の残基位置でどのような変異や保存を選択してきたか」という実測された直接の進化的変異履歴を直接観測することはできません。
2. 普遍的な構造ルールと、局所的・機能的な選択圧の違い
- PLMが捉える情報: タンパク質全般に共通する「アミノ酸配列の妥当性」「二次構造・立体構造の保持に必要な物理化学的制約」などの大域的・普遍的なパターンです。
- PSSMが捉える情報:特定の酵素や機能ドメイン(例:Casタンパク質など)の活性部位や相互作用界面において、「生物の適応進化の過程で生じた特定位置への局所的な淘汰圧(変異許容度)」です。
全タンパク質の共通ルールを背景に持つPLMの表現では、特定ファミリーの局所的な機能的保存性や特異的な変異傾向といったピンポイントのシグナルが平均化され、希釈されることがあります。
3. データベースの偏りと遠縁・マイナーファミリーへの解像度
- 大規模データベース(UniRefなど)にはデータ量の偏り(バイアス)が存在し、PLMの内部表現はサンプル数の多いメジャーなタンパク質ファミリーのパターンに引き寄せられやすくなります。
- Casタンパク質のように多様性が非常に高く、遠縁な相同関係が問題となるマイナーな分類群では、PLM単体では個別のサブタイプを識別するための細かな進化シグナルの解像度が不足する場合があります。
- PSSMはクエリに対してその都度ローカルなホモログを集めて集計するため、データ全体での頻度に関わらず、そのタンパク質ファミリー固有の進化情報をダイレクトかつ高精細に抽出できます。
4. 表現の性質の違い(抽象的な潜在表現 vs 明示的な置換確率)
- PLM:高次元ベクトルの中に、構造・機能・文脈など多角的な情報を多義的・抽象的(Implicit)に保持しています。
- PSSM: 各残基位置における20種のアミノ酸の出現・置換頻度をログオッズスコアとして明示的(Explicit)に表現した数値行列です。
下流の機械学習モデル(SVMやランダムフォレストなど)にとって、PLMの複雑な潜在表現から「位置ごとの保存度スコア」を逆算して解読するよりも、直接的な置換確率(PSSM)が並列で与えられる方が、明確な判定境界をはるかに形成しやすくなります。
このように、PLMが捉える「汎用的な文脈・高次構造のパターン(コンテキスト情報)」と、PSSMが捉える「特定系統の直接的な変異履歴(進化プロファイル)」は、情報の抽象度も抽出プロセスも根本的に異なります。
そのため、両者の特徴量を融合することで、単一の言語モデルでは補いきれないファミリー特異的な進化シグナルが相補的に補強され、分類・予測精度の格段な向上に繋がります。
関連crisp_bio記事
- 大規模言語モデルによるCRISPR-Cas12aクレードの発見. crisp_bio 2025-08-07. https://crisp-bio.blog.jp/archives/39171921.html
"PrePssmCas: fusing pre-trained features and PSSM features for Cas protein classification” Ningyi Zhang(1), Yufeng Zhao(1), Chenhan Luo(1), Zhiwei Peng(1), Qianqian Shi(1,2). BMC Bioinformatics. 2026-09-25. https://doi.org/10.1186/s12859-026-06569-y
- College of Forestry, Northwest A&F University, No. 3 Taicheng Road, Yangling, 712100, Shaanxi, China
- Corresponding author


コメント